あらゆるチェックをクリアするファイル
ファイルのセキュリティパイプラインは、めったに疑問視されることのない前提、すなわち「ファイルには1つのタイプしかない」という前提に基づいて構築されています。検出エンジンがそのタイプを特定し、ポリシーに基づいてファイルを転送します。その後、下流にあるすべてのエンジン(マルウェア対策、サンドボックス、サニタイゼーションなど)が、そのタイプとしてファイルを分析します。
多形式ファイルはこの前提を覆します。1つのバイトストリームが、完全に有効なGIFであると同時に、完全に有効なJavaアーカイブでもあることがあり得ます。この手法は、JPEGでありながらRARアーカイブでもあるファイルや、論理的な終了位置を超えて完全なZIPファイルを格納しているPDFにも適用できます。それぞれの部分はそれ自体で規格に準拠しているため、個々のフォーマットパーサーからは何の問題も検出されません。
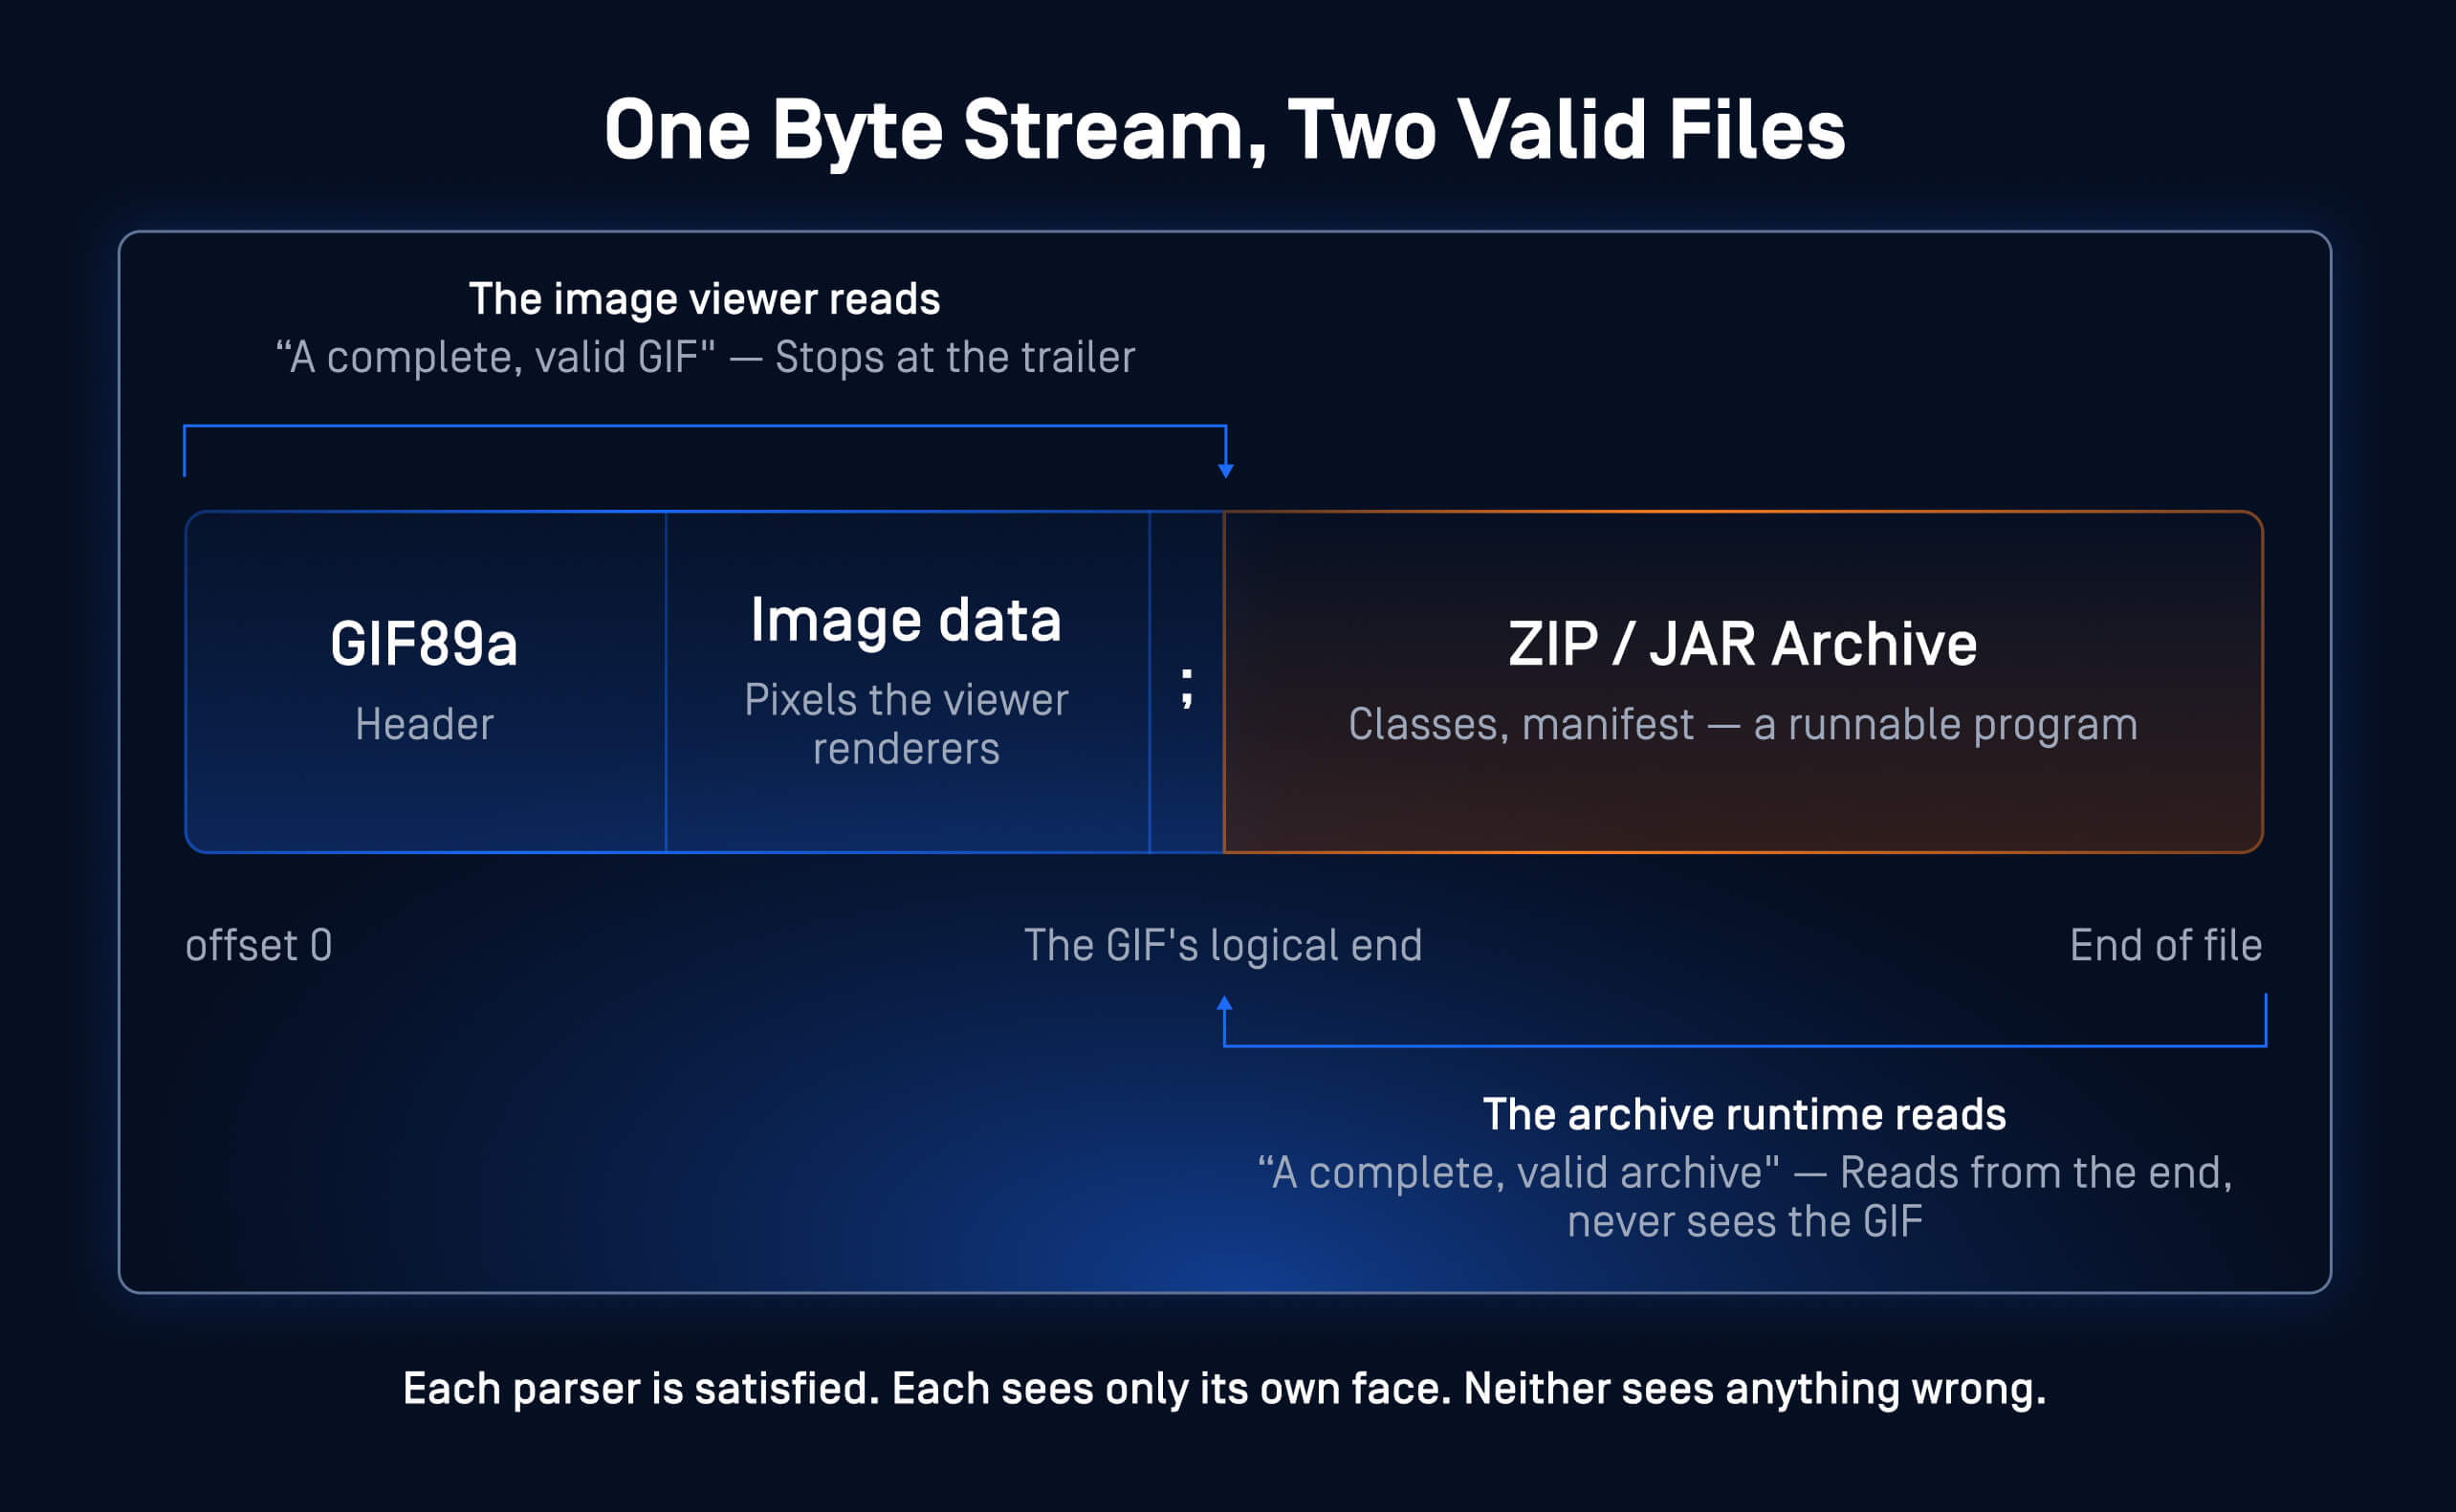
1つの画像に多言語を詰め込んだもの:定番のGIF+JAR。2つのパーサー、2つのエントリポイント、1つのファイル、そしてどの顔も完全に有効です。
セキュリティ上の影響は明確です。パイプラインは、検出したファイルタイプとしてそのファイルをスキャンし、 他の形式のデータはそのまま通過してしまいます。スクリプトでもある画像は、Webアプリケーションによって配信されると、保存型XSSとなります。画像の「表面」の裏に隠されたアーカイブは、コンテンツフィルターをすり抜けてペイロードを運び込みます。この考え方に基づいて構築された攻撃チェーンは、古典的なGIF+JARの組み合わせから、ステガノグラフィを活用したエクスプロイトの配信に至るまで、20年近く前から公知となっています。 各画像は個別に検査すると無害であるため、マルウェア対策エンジンは依然としてこれらをほとんど検知できていません。
エンジンが「もう一つの顔」を見つける仕組み
当社のファイル構造検証エンジンは、スキャンされたすべてのファイルに対して、フォーマット処理が行われる前の前処理ステップとして、多言語検出機能を追加しています。この設計は、3つの考え方に基づいています。
- ストリーム全体をスキャンします。スキャナは、ファイル全体をフォーマット・マジック・シグネチャのリストと照合します。ストリーム内のどこかに別のフォーマットが検出された場合、そのファイルのタイプがすでに特定されていたとしても、その正確なオフセットとともに表示されます。これには、PDFのファイル終了マーカーの後に追加されたシグネチャや、画像のピクセルデータの奥に隠されたシグネチャも含まれます。
- フォーマットが正当にどこで終了するかを把握すること。 Container といったフォーマットは、規定上、内部に他のファイルを格納することが許されています。ZIPファイル内の画像は、単なるコンテンツの一つです。本検出ツールは、各コンテナの構造に基づいて、そのコンテナの真の終了位置を特定します。PDFのトレーラー、ZIPの中央ディレクトリ、およびOLE(Object Linking and Embedding)複合ファイルのセクタ割り当てが、それぞれその境界を示しています。PDFの解析では、増分更新も考慮されます。 その構造の外側にある署名のみが、第二の境界としてカウントされます。この構造的な境界こそが、真の多形式判定と、あらゆる通常のアーカイブにおける誤検知とを区別するものです。
- 非難する前に確認してください。エンジンは、データストリームから各候補を抽出し、報告する前に当社のファイルタイプエンジンで個別に再識別を行います。非構造化データと識別された候補は破棄されます。「判定」とは、そのオフセット位置で別のフォーマットが実際にパースされることを意味します。単体の不要な魔法のバイトだけでは、決して判定は出ません。
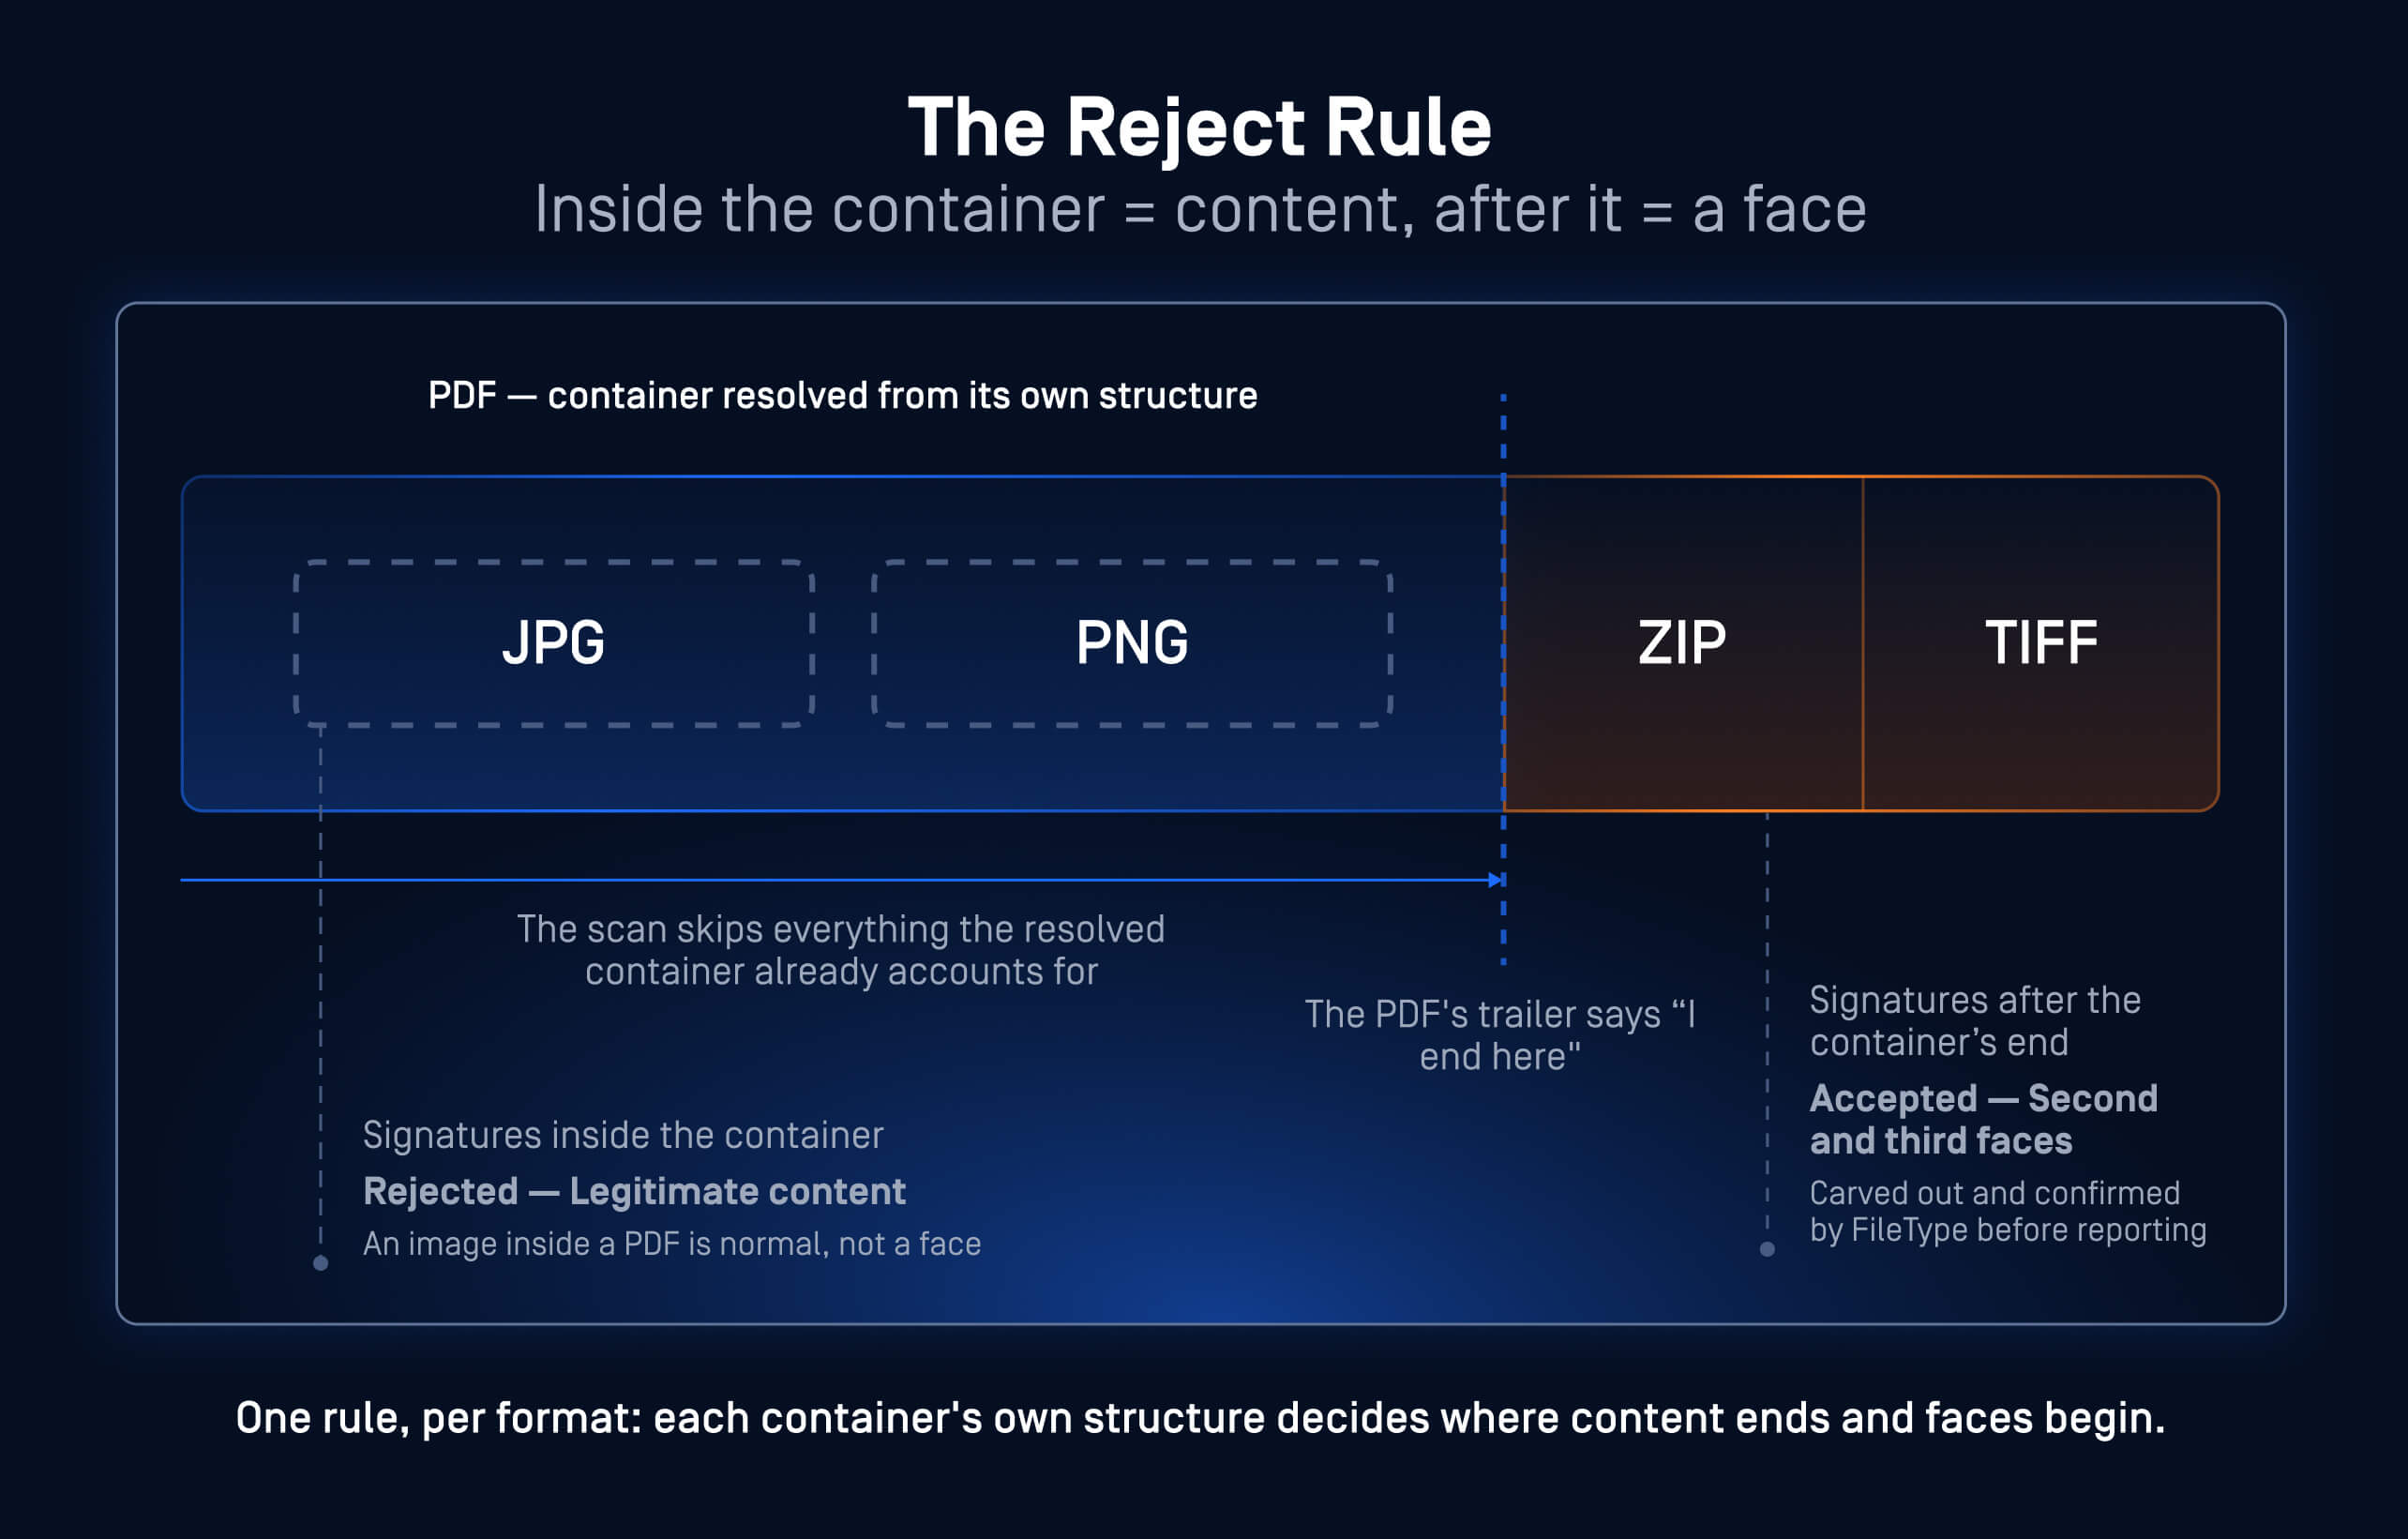
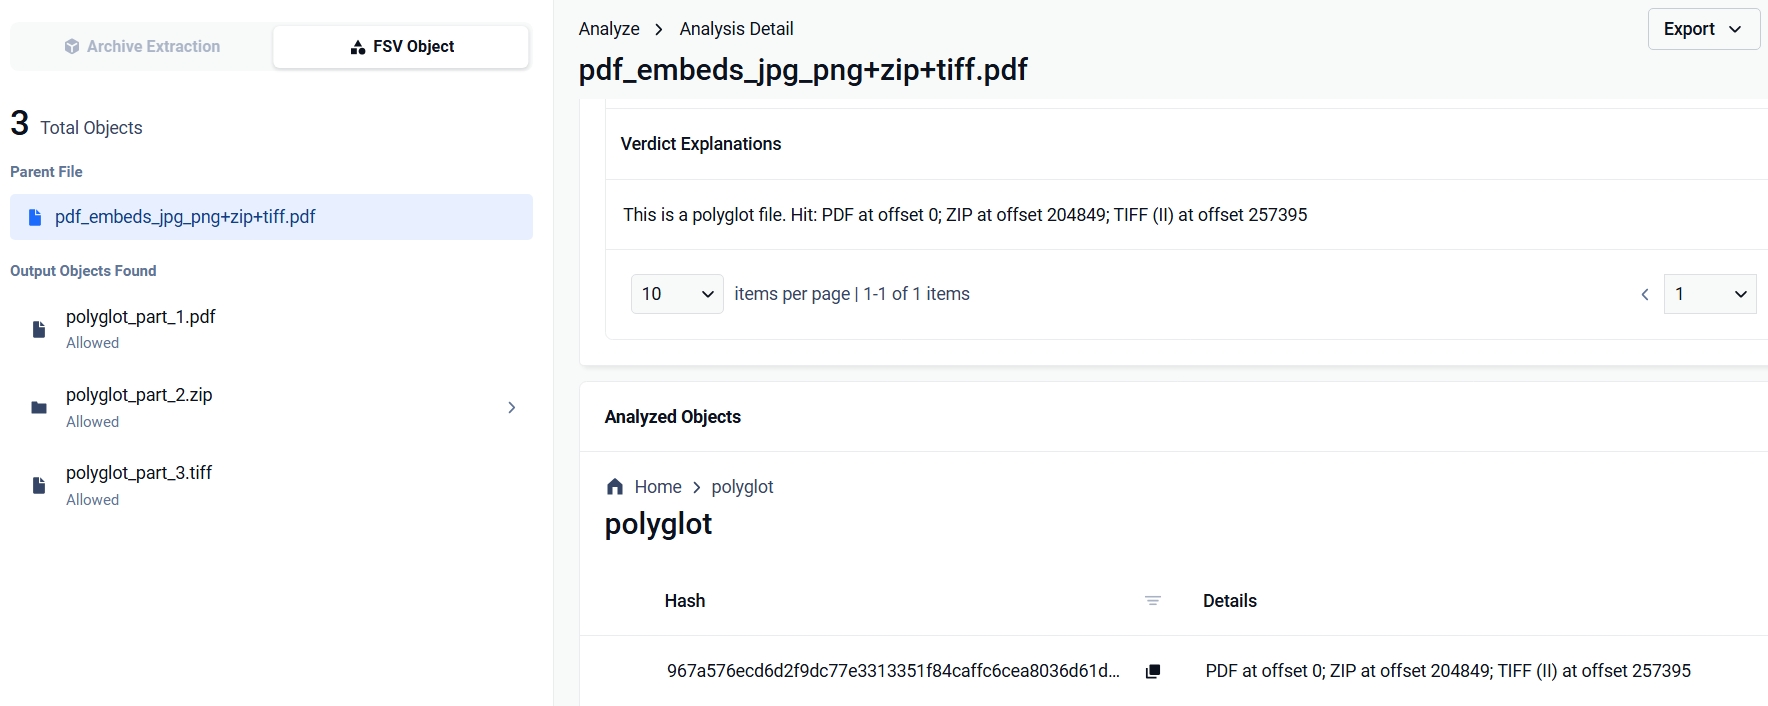
実際のサンプルから抜粋したものです。JPGとPNGが埋め込まれたPDFで、その論理的な末尾の後にZIPとTIFFが追加されています。判定結果ではZIPとTIFFが言及されていますが、埋め込まれた画像については言及されていません。
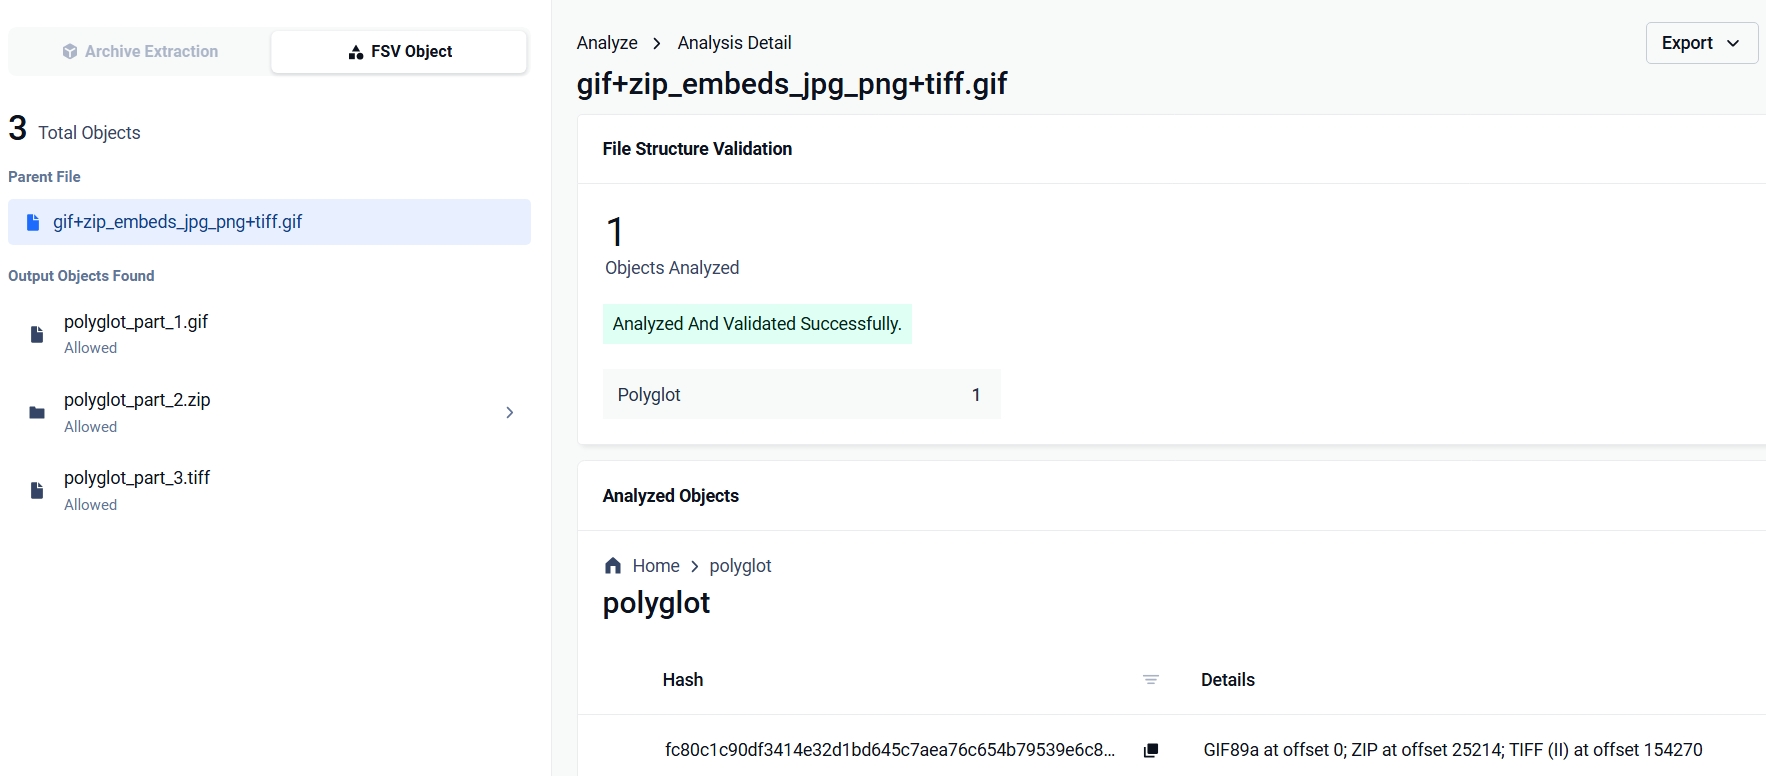
結果には、各フェイスとそのオフセットが報告されます。たとえば、1つの.gifファイルがアップロードされた場合、オフセット0の位置ではGIF89aとして識別され、ストリームのさらに奥ではZIPアーカイブとして識別されます。残りの処理はポリシーによって決定されます。つまり、検出結果を報告するか、ヒット項目を列挙した説明を添えてファイルを完全にブロックするか、のいずれかです。
検出から解剖まで
検出は解決策の半分に過ぎません。なぜなら、ポリグロットの真骨頂は、個々の顔がそれ単体では無害に見える点にあるからです。検出後、エンジンはファイルを解析します。確認された各顔は、そのフォーマット、オフセット、サイズとともに、個別のオブジェクト(polyglot_part_1.pdf、polyglot_part_2.zip など)としてエクスポートされます。エンジンは、それらをMetaDefender Core™ワークフローに引き渡し、その正体に応じた完全な処理が行われるようにします。
この動作について、稼働中のMetaDefender Core™インスタンス上でエンドツーエンドで検証を行いました。
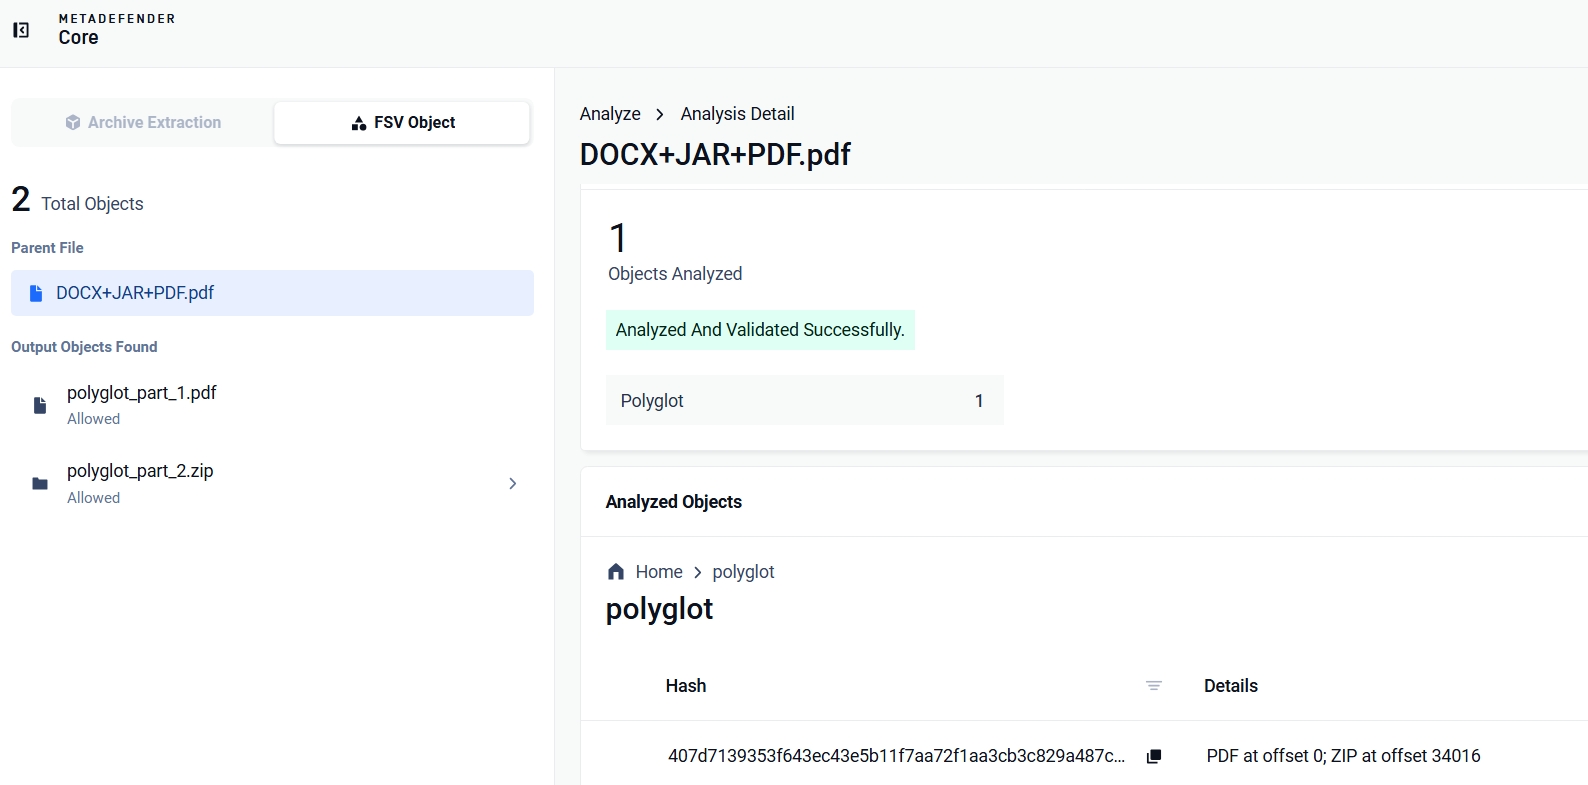
エンジンは、Word文書(PDF+JAR+DOCXの複合ファイル)を密かに埋め込んだPDFサンプルを、PDFレイヤーとZIPレイヤーに分割しました。JARとDOCXはいずれもZIPコンテナであるため、1つのZIPレイヤーで両方の仕様を満たすことになります。その後、ファイルタイプエンジンがそのレイヤーをDOCXとして識別し、Deep CDR™テクノロジーによって個別に処理されました。隠されたレイヤーは、その回避を目的として構築されたのと同じ処理を受けることになります。
「精度こそが難しいところだ」
マジックバイトは、何の問題もないファイルにも自然に存在するため、真の技術的投資とは、「狼が来た」と誤報を出さないようにすることにあります。カメラで撮影した写真には、独自のJPEGシグネチャを含むEXIFサムネイルが埋め込まれています。Office文書には、コンテナ構造内に画像が埋め込まれています。Media ファイルには、圧縮ヘッダーのように見えるバイト列がランダムに含まれています。 検出ロジックは、正当な構造によってすでに説明がついているバイトを除外しており、この堅牢化はフォーマットごとに継続的に拡張されています。すべてのカメラ写真をフラグ付けしてしまう検出器は無効化され、無効化された検出器は誰の保護にもなりません。
実際の多言語話者を対象にテスト済み
実際の多言語サンプルを、ファイル構造検証エンジンを搭載した稼働中のMetaDefender Core™環境に投入しました。すべてのサンプルが検出され、各文字列は正確なバイトオフセットで特定されました:
サンプル | 検出された顔(オフセット) | 成果 |
Word文書をPDFに埋め込む(PDF+JAR+DOCXを1つのファイルに統合) | PDF:0 · ZIP:34,016 | 顔画像を抽出;Deep CDR™ テクノロジーにより、隠された DOCX ファイルの不適切な情報を除去 |
アーカイブと別の画像を隠したGIF | GIF89a @ 0 · ZIP @ 25,214 · TIFF @ 154,270 | 検出されました |
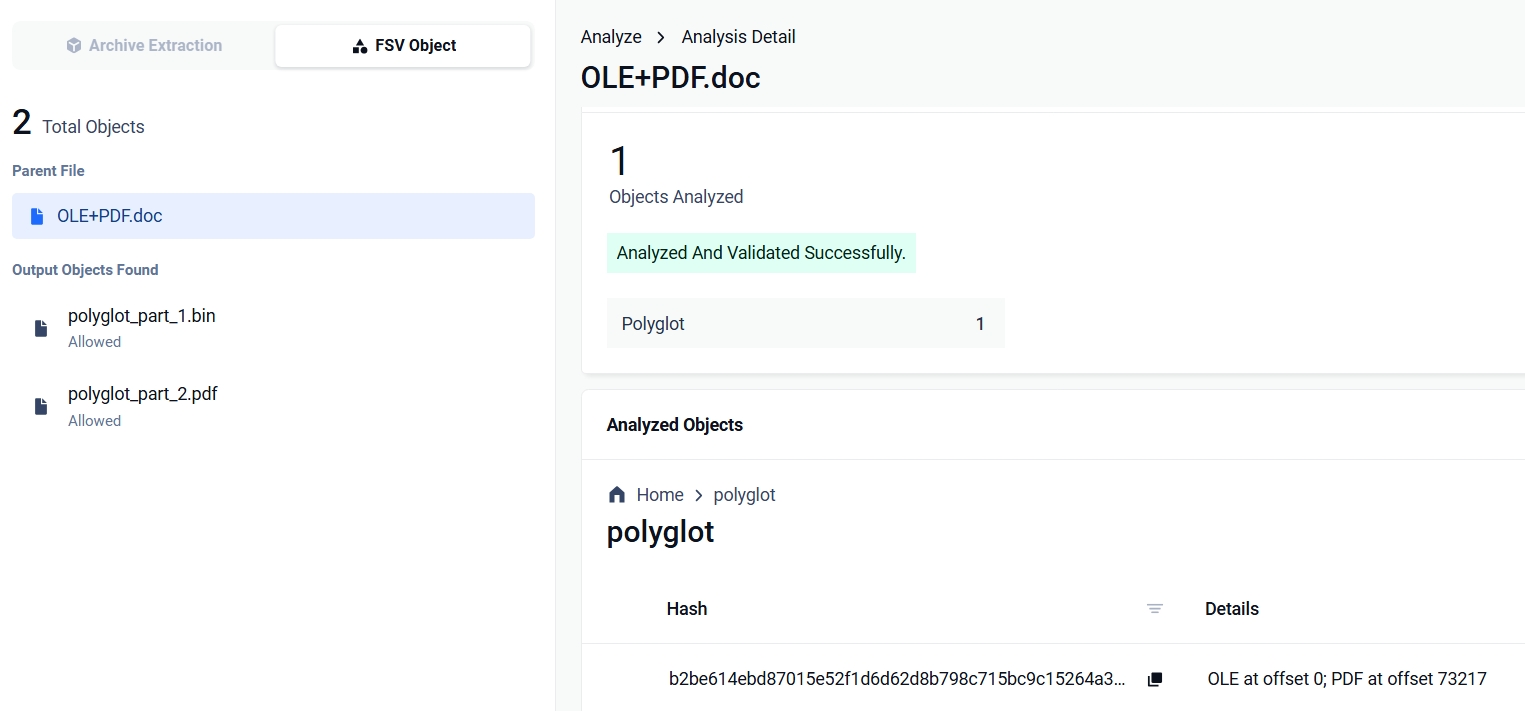
PDFを埋め込んだOffice文書 | OLE @ 0 · PDF @ 73,217 | 検出されました |
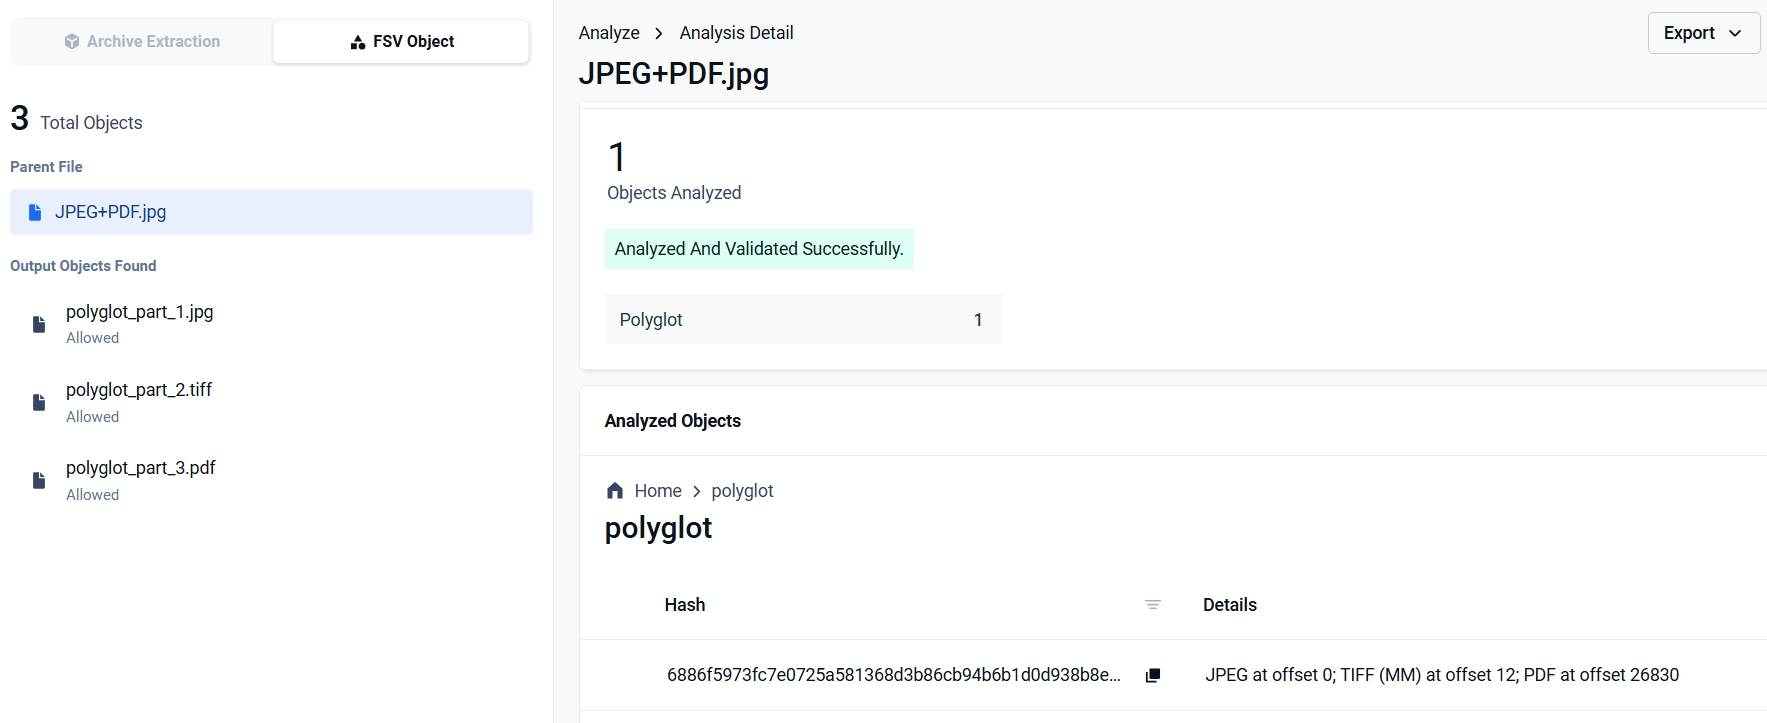
JPEGにPDFを埋め込む | 3つの顔、PDFを添付(26,830) | 検出されました |
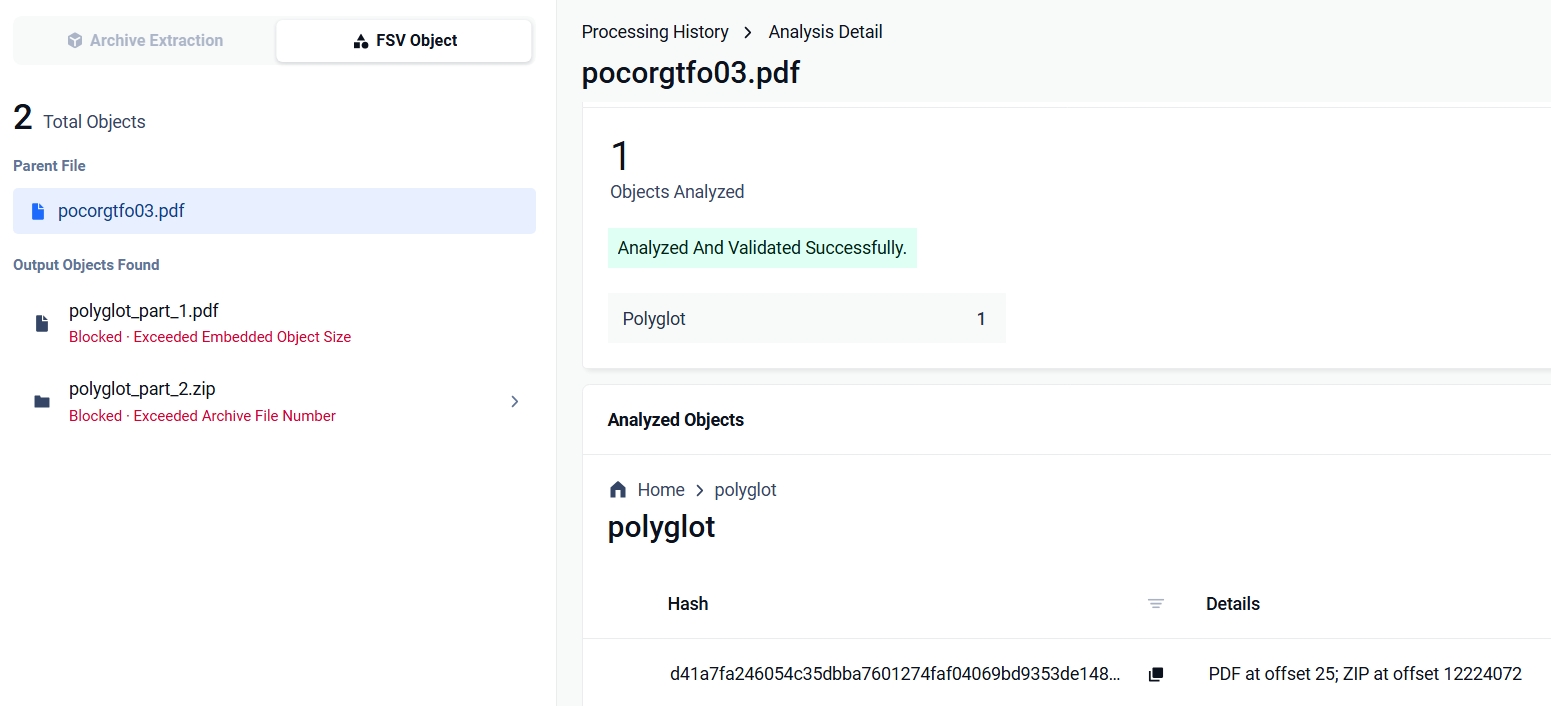
PoC‖GTFO 第3号、PDF+ZIP形式の多言語対応で作成されたセキュリティ研究誌、26 MB | PDF:25 · ZIP:12,224,072 | 検出:フルスキャンにより、12 MBの深さで2つ目のフェイスが見つかりました |
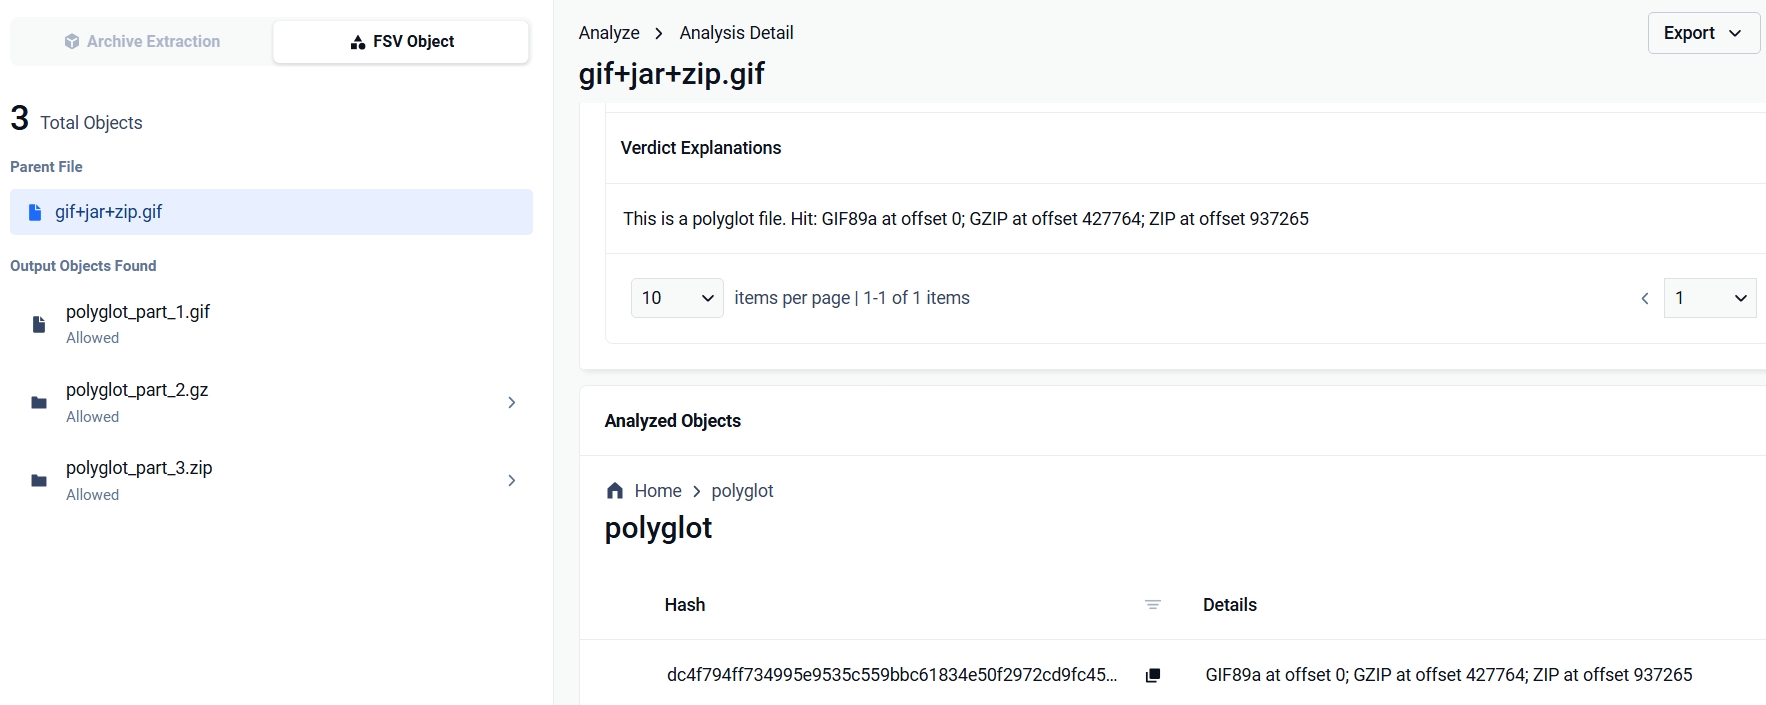
GZIPストリームとJavaアーカイブを含むGIF | GIF89a @ 0 · GZIP @ 427,764 · ZIP @ 937,265 | ブロック済み |
JPGとPNGが埋め込まれたPDFに、ZIPとTIFFが追加されたもの | PDF @ 0 · ZIP @ 204,849 · TIFF @ 257,395 | ブロックされました。埋め込まれた画像は正しく報告されませんでした。 |
最後の行は、リジェクトルールが適用された例です。判定では、追加されたZIPおよびTIFFが指定され、PDF内の画像は無視されています。コンテナリゾルバーは、これらをPDF自体のコンテンツとして扱いました。そのファイルに対するMetaDefender Core™の結果JSON(抜粋):
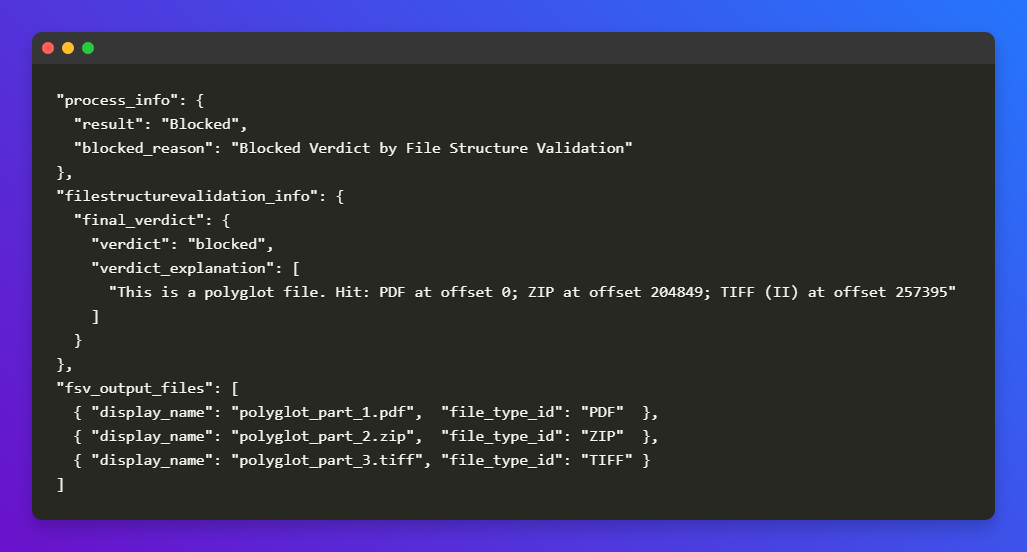
fsv_output_filesリストは、前述の「解剖」をリアルタイムで反映したものです。つまり、3つの面が切り出され、それぞれ独立したオブジェクトとしてワークフローに返されるのです。
以下は、MetaDefender Core™における各サンプル結果のスクリーンショットです:
対応範囲と構成
本日の対応範囲は、攻撃者が実際に組み合わせて使用する形式、すなわちPDF、ZIP、OLE複合ファイル、PNG、GIF、JPEG、TIFF、RAR、GZIP、および7zを網羅しています。
コンテナの構造的な終了位置の判別機能は、コンテナ形式に適用されます。この機能は「構成優先」の形で提供されます。つまり、検出、ブロック、およびファイル全体のスキャンはそれぞれポリシースイッチとして扱われるため、運用担当者は導入ごとに「可視化」と「強制適用」のいずれかを選択することになります。
結論
2つの有効なフェイスを含むファイルは、それらを単一のタイプに割り当てるあらゆるパイプラインを無効化してしまいます。そして、単一タイプの検出は、ほとんどのスキャンスタックの基盤となっています。構造的なポリグロット検出は、すべてのフェイスを特定し、それぞれが正しく解析されることを証明することで、このギャップを埋めます。これにより、アプリケーションが誤ったインタプリタを選択する前に、ポリシーによってそのファイルをブロックすることが可能になります。
現在、一般的な攻撃形式に対する検知がサポートされています。残りのアーカイブ形式に対するコンテナ末尾の解析については、ロードマップに沿って順次対応していく予定です。
File Structure Validation が、お客様の環境内を流通する各種ファイル形式をどのように処理するかをご覧ください。