2025年6月、シスコは自社のIdentity Services Engineに存在する最高深刻度の脆弱性「CVE-2025-20282」を公表した。根本的な原因は、ファイルのアップロード時にファイルの妥当性チェックが行われていなかったことにあり、これにより、認証されていない攻撃者が細工されたファイルを特権ディレクトリに配置し、root権限で実行することが可能となる恐れがあった。この不具合は、検出プロセスの上流、つまりスキャンエンジンが動作する前にシステムがファイルを受け入れる段階で発生していた。
この傾向は、特定の製品に限ったことではありません。スタック内のエンジン数が制約となることはめったにありません。ファイルを評価するには、まずそのファイルを解析する必要がありますが、最近のフォーマットでは、解析が必ずしも到達できないような形でコンテンツがネストされていることがあります。
なぜ検査結果に異常がなかったのか
署名ベースのスキャンは、バイトの照合によって機能します。エンジンには、既知のマルウェアから抽出されたハッシュ値やバイトパターンのデータベースが格納されており、ファイルが検出されるためには、そのファイルに一致するバイトが存在する必要があります。しかし、ネストされたコンテンツの場合、いくつかの要因によってこの検出が妨げられることがあります。
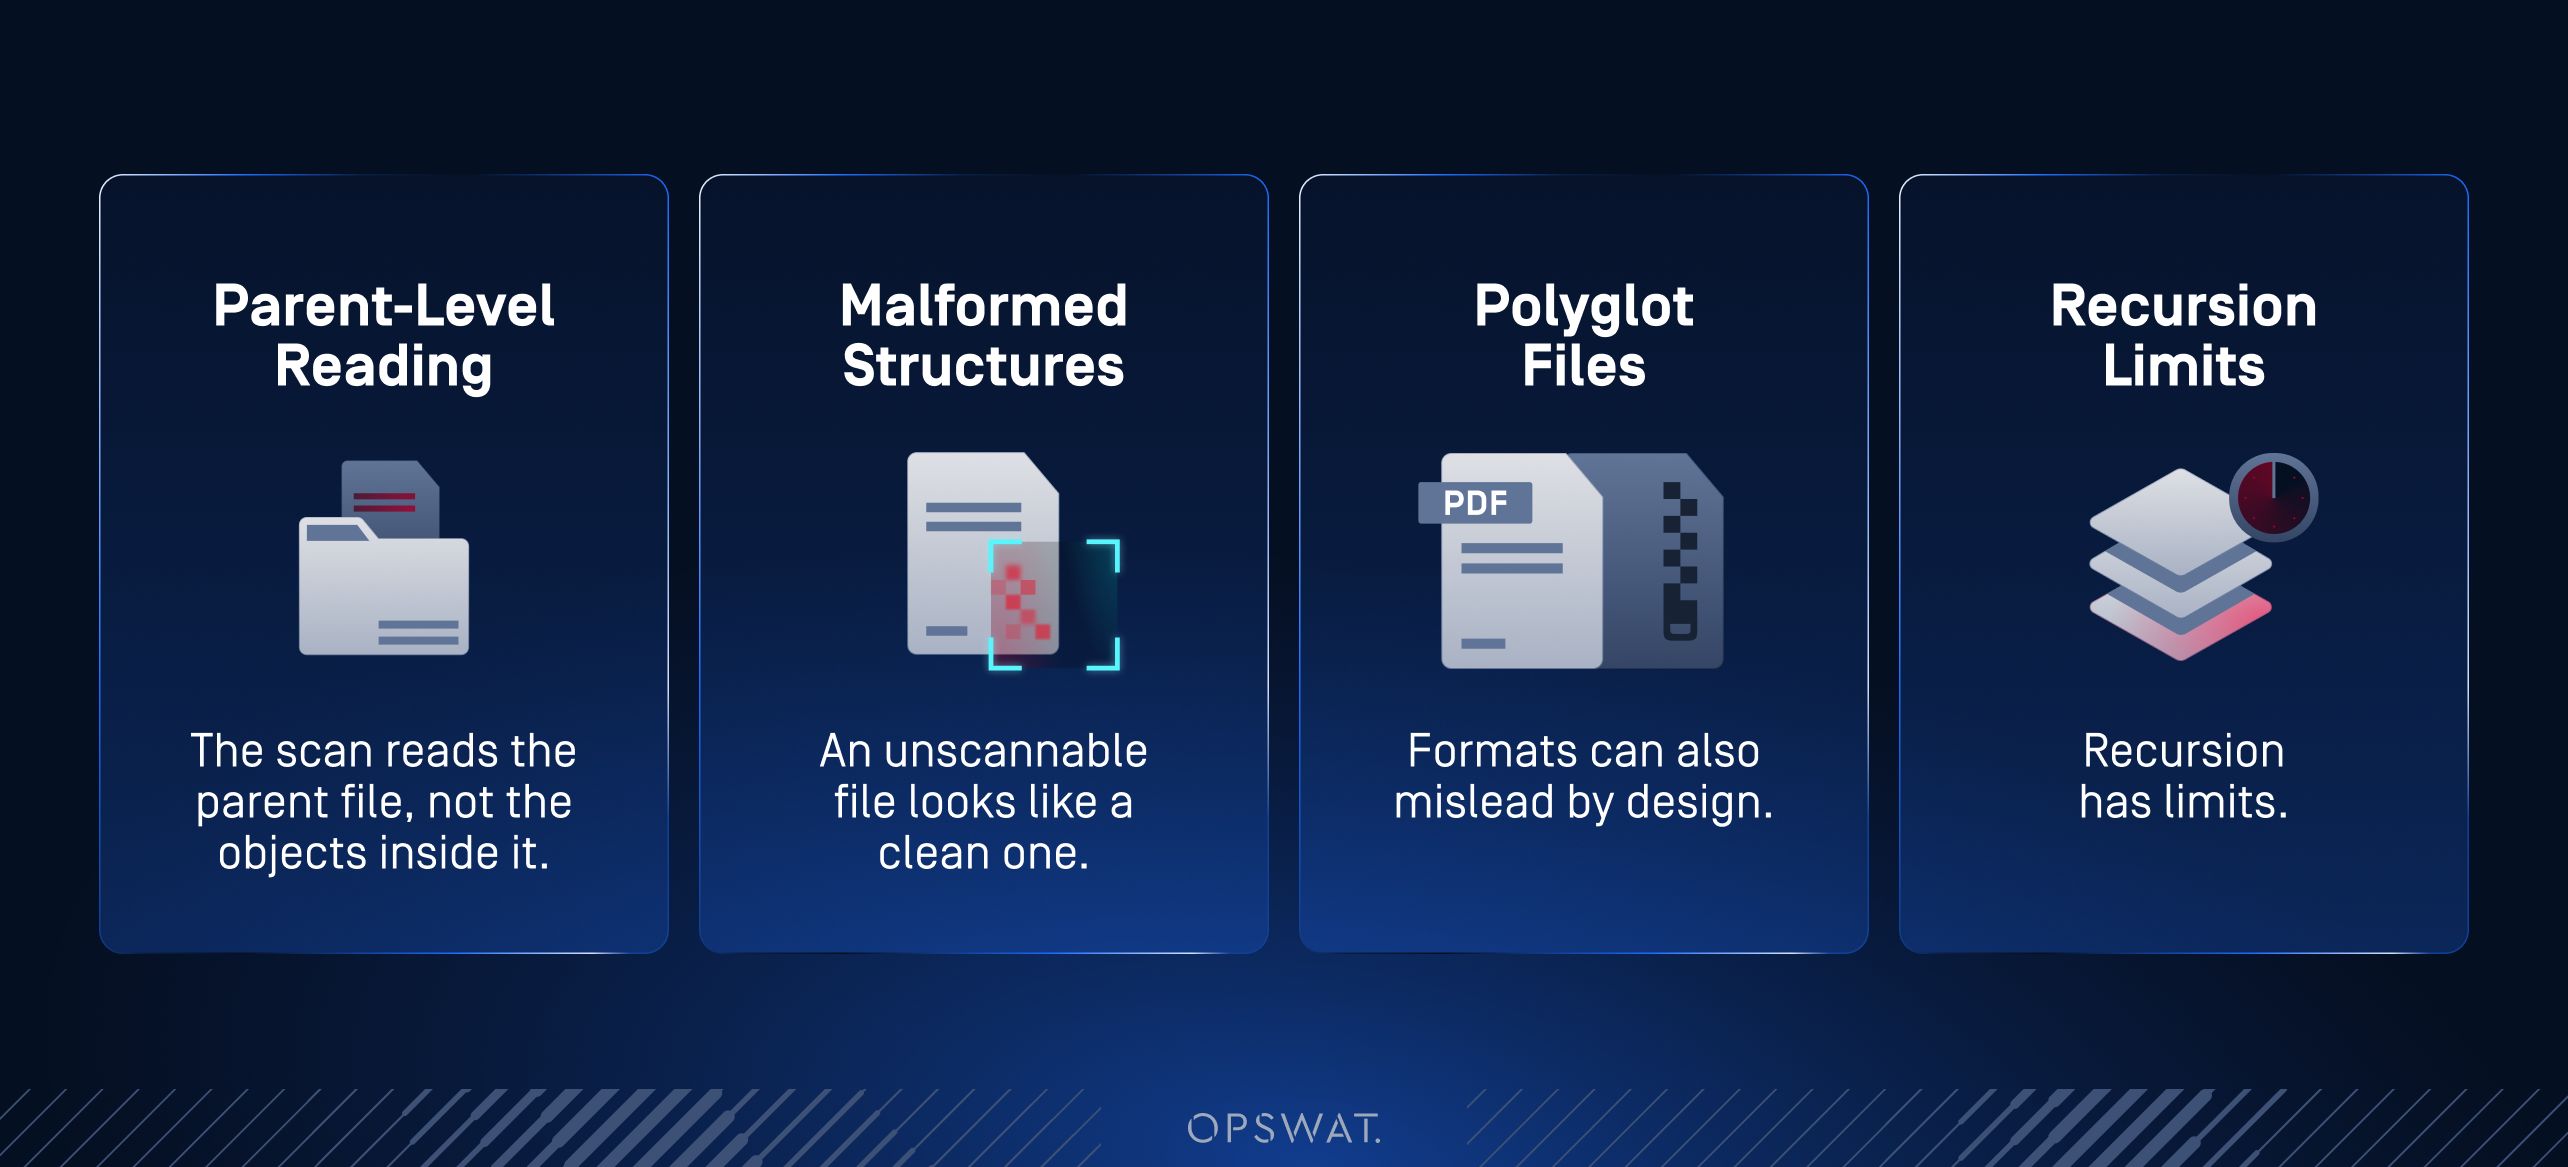
- スキャンは、ファイル内のオブジェクトではなく、親ファイルを読み取ります。スキャンでは、対象となるファイルを単一のバイナリオブジェクトとして扱い、シグネチャデータベースと照合します。ネストされたコンテンツは圧縮またはエンコードされた形式で保持されているため、ドキュメントストリーム内に含まれる実行ファイルは、ディスク上の同じ実行ファイルとバイトシーケンスをほとんど共有しません。データベースが検索対象とするパターンは、保存されたファイルには存在せず、そのストリームが解凍されて初めて照合可能になります。
- スキャン不可能なファイルは、正常なファイルのように見えます。 構造の不備により解析が中断されます。エンジンは評価を完了できないため、ファイルはブロックされるのではなくスキップされ、「評価できませんでした」という意味の結果が、「何も見つかりませんでした」という意味の結果と区別がつかないまま、下流に伝達されます。
- フォーマットは、その設計上、誤解を招くこともあります。多言語ファイルは2つのフォーマット仕様を同時に満たしているため、あるパーサーはその仕様を満たしていると判断する一方で、ファイル自体はまったく別のものとして振る舞うことがあります。
- 再帰には限界があります。ネストされたコンテナには、深さの制限やスキャンタイムアウトが設けられています。これは、無制限の再帰自体がサービス拒否(DoS)のリスクとなるため、当然の措置です。その境界より下に配置されたペイロードは決して評価されず、エンジンが到達できない深さにペイロードを配置する方が、エンジンを無効化するよりもはるかに容易です。
その結果、一見したほど多くのことを示していない判定が下されることになる。「クリーン」という結果は、エンジンが解析できたファイルの一部において、既知のパターンが一致しなかったことを意味するに過ぎない。これは、ファイル内部の構成要素について何も示しておらず、エンジンが解析しなかった部分についても何も述べていない。
各レイヤーにはそれぞれの役割がある。そのうちの1つが欠けていた
シグネチャベースのスキャンは、決して単独で機能するものではありません。現代のファイルセキュリティスタックは、設計上、多くの場合多層構造になっており、その周囲の層は、パターンマッチングではカバーできない部分を補うために存在しています。
ファイルタイプの識別とは、宣言された拡張子ではなく、ヘッダーからファイルの真のタイプを判別するものです。これは設計上、高速かつ表面的な処理であり、ファイルの内容そのものではなく、そのファイルをどこに配置すべきかを決定するために構築されています。動的解析は、制御された環境下でファイルの挙動を観察するものです。これは未知の脅威に対処するのに適したツールであり、すべてのファイルに適用するのではなく、選択的に適用した場合に最も効果を発揮します。
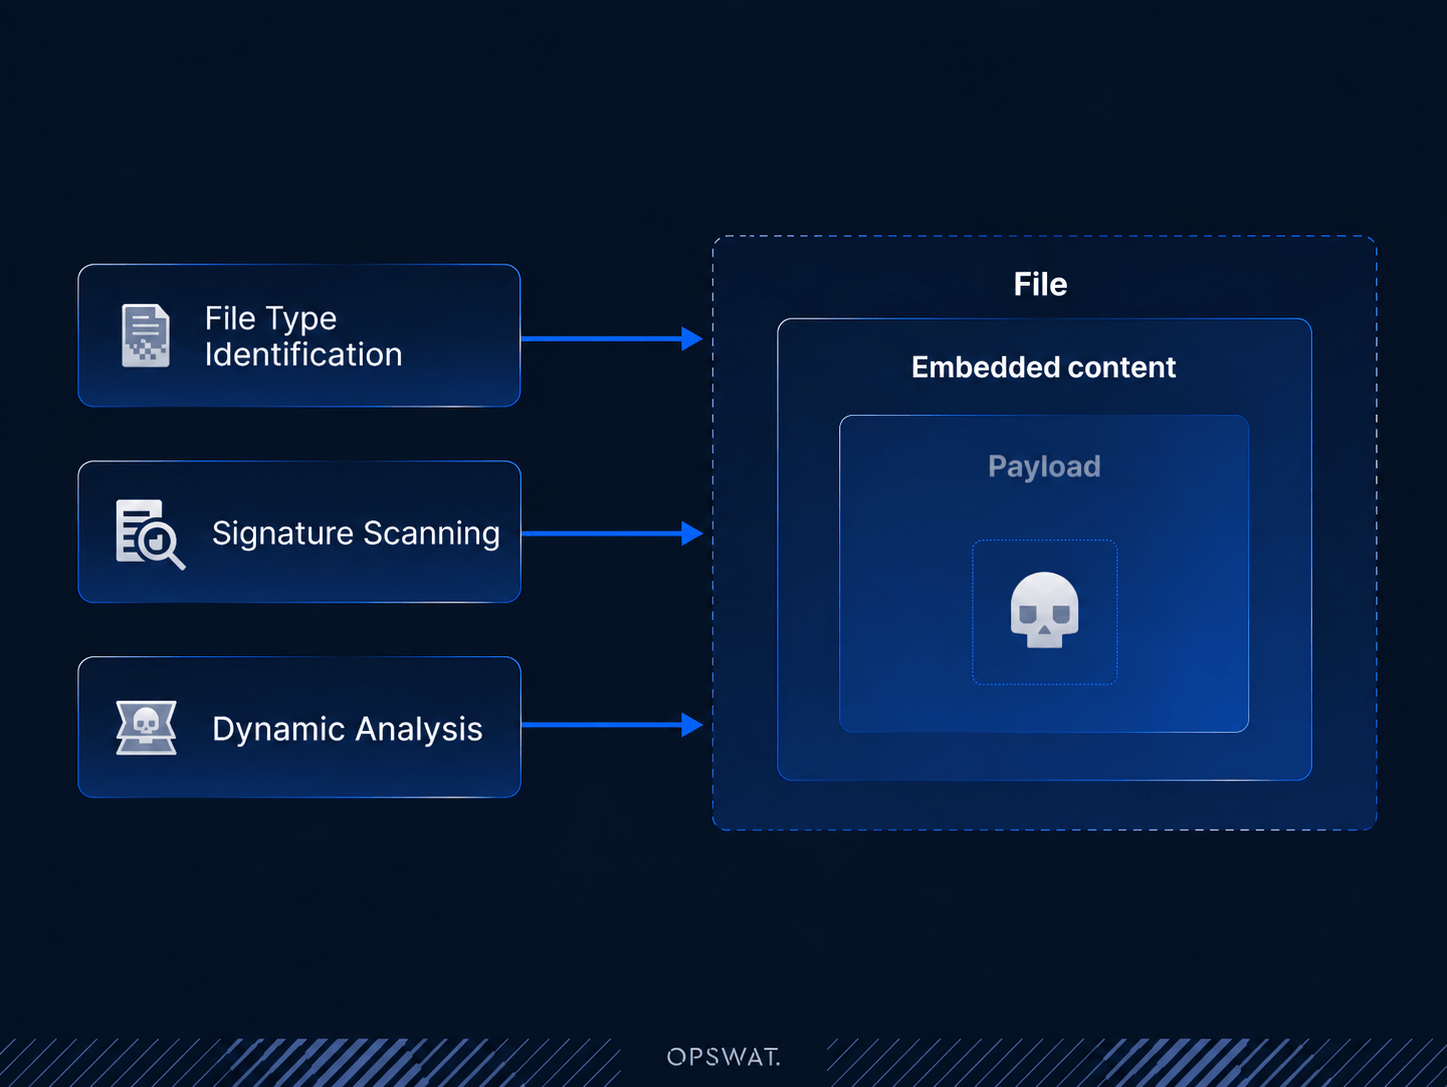
各レイヤーはそれぞれの役割を果たしますが、ペイロードがそれを運ぶファイルから分離されない場合や、深度制限を下回っている場合、そのコンテンツはこれらのレイヤーのいずれにも到達しないため、レイヤーを追加しても何の役にも立ちません。この「死角」は、データベースファイル、GISデータ、AIモデルファイルなど、サニタイズ処理の経路がまったく存在しないフォーマットにおいて最も広範囲に及びます。これらのフォーマットは再構築できないため、通常であれば未知の脅威を検知するはずのレイヤーが、その性質上利用できないのです。
欠けているのは、まず構造的な「グラウンドトゥルース」を確立することのみを目的としたレイヤーです。具体的には、ファイルをそのフォーマット仕様に基づいて解析し、埋め込まれたすべてのコンポーネントを抽出し、それらのコンポーネントを個別に下流のすべての処理で利用できるようにすることです。これこそが、「ファイル構造検証」が解決するために構築された問題なのです。
ファイル構造の検証がどのようにギャップを埋めるか
ファイル構造の検証は、スタックの他の処理が開始される前に実行されます。GIS、データベース、AIモデル形式など、160種類以上のファイル形式について、そのフォーマット仕様に基づいてファイルを検証し、ファイルを構成要素に分解して、それぞれの構成要素にポリシーを適用します。
オブジェクトは、それらを評価するための機能を備えたエンジン(Metascan™Multiscanning 、Adaptive Sandbox 、Proactive DLP™ Technology、またはOPSWAT Alin AI)にルーティングされます。親ファイルは、必要に応じて、サニタイズ処理を行うためにDeep CDR™ Technologyへと送られます。
ここで重要なのは、スキャンへの影響です。シグネチャ照合は、既知のマルウェアを特定するための最も高速かつ経済的な方法であり続けており、ファイル構造検証はその作業に取って代わるものではありません。これは、エンジンに渡される対象を変えるものです。ペイロードは、すでに解凍され、分類済みのスタンドアロンファイルとして届くため、エンジンは親ファイルの中に埋もれた圧縮された断片ではなく、オブジェクトそのものと照合を行うことになります。 検出エンジンには、そのデータベースが認識するように構築された正確なバイトデータが渡され、その時点でエンジンはこれまで通り優れた性能を発揮します。
ファイルで確認する
これを最も明確に示す方法は、スキャンを通過しながらもペイロードを保持しているファイルを示すことです。そこで、無害なPDFファイルの中に悪意のあるペイロードを隠した概念実証(PoC)を作成しました。このサンプルを複数のマルウェア対策エンジンで検査したところ、すべて「クリーン」という結果が返されました。
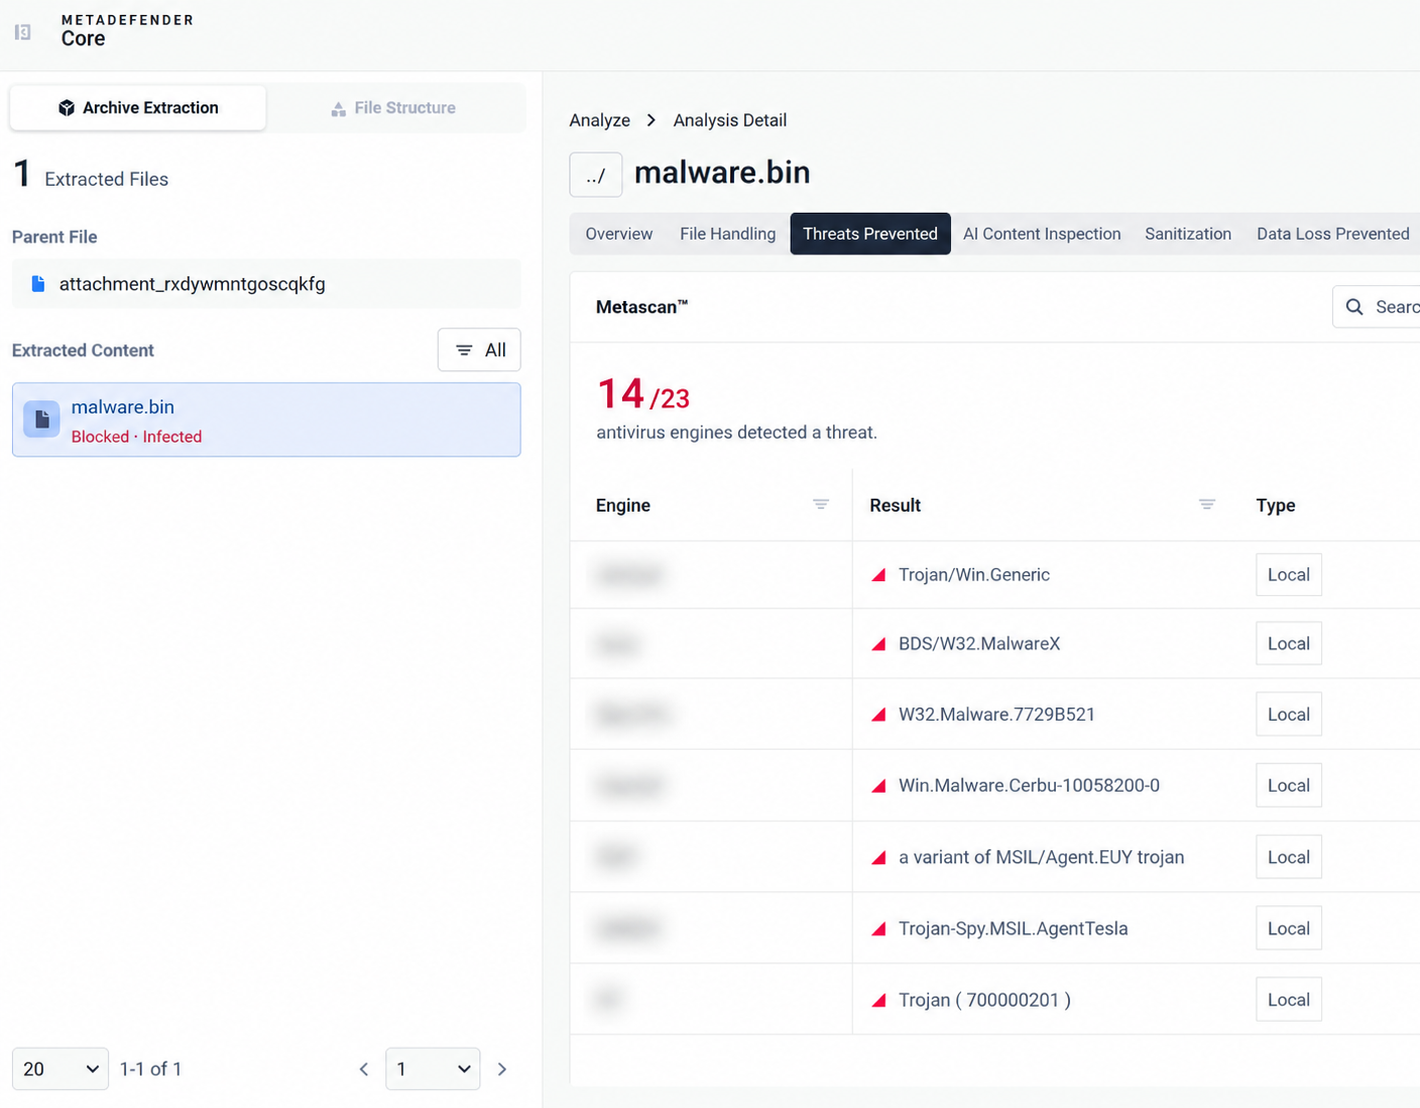
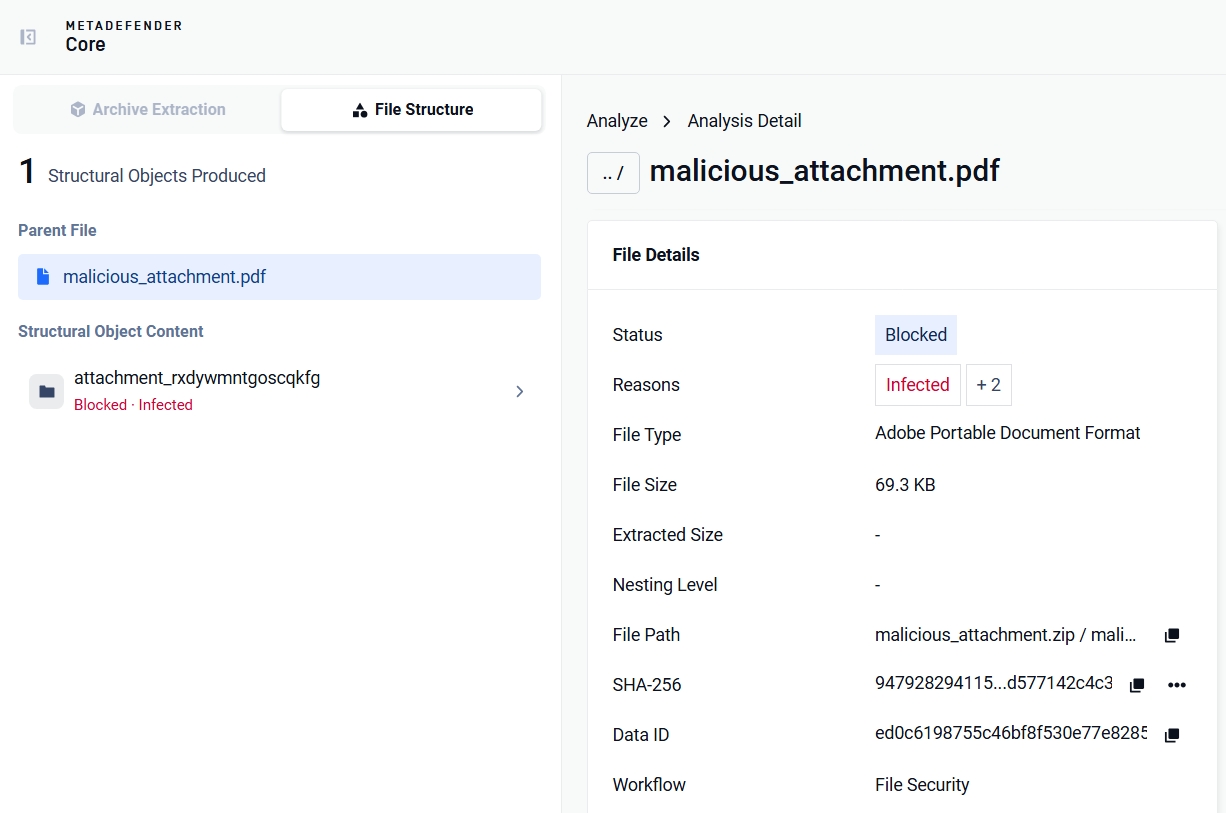
次のステップとして、MetaDefender Core™ で「ファイル構造検証」機能を有効にして、このファイルをスキャンします。親ファイルのネストされたコンポーネントを抽出した後、「ファイル構造検証」機能は出力オブジェクトを後続のエンジンに送信し、さらなる分析を行います。
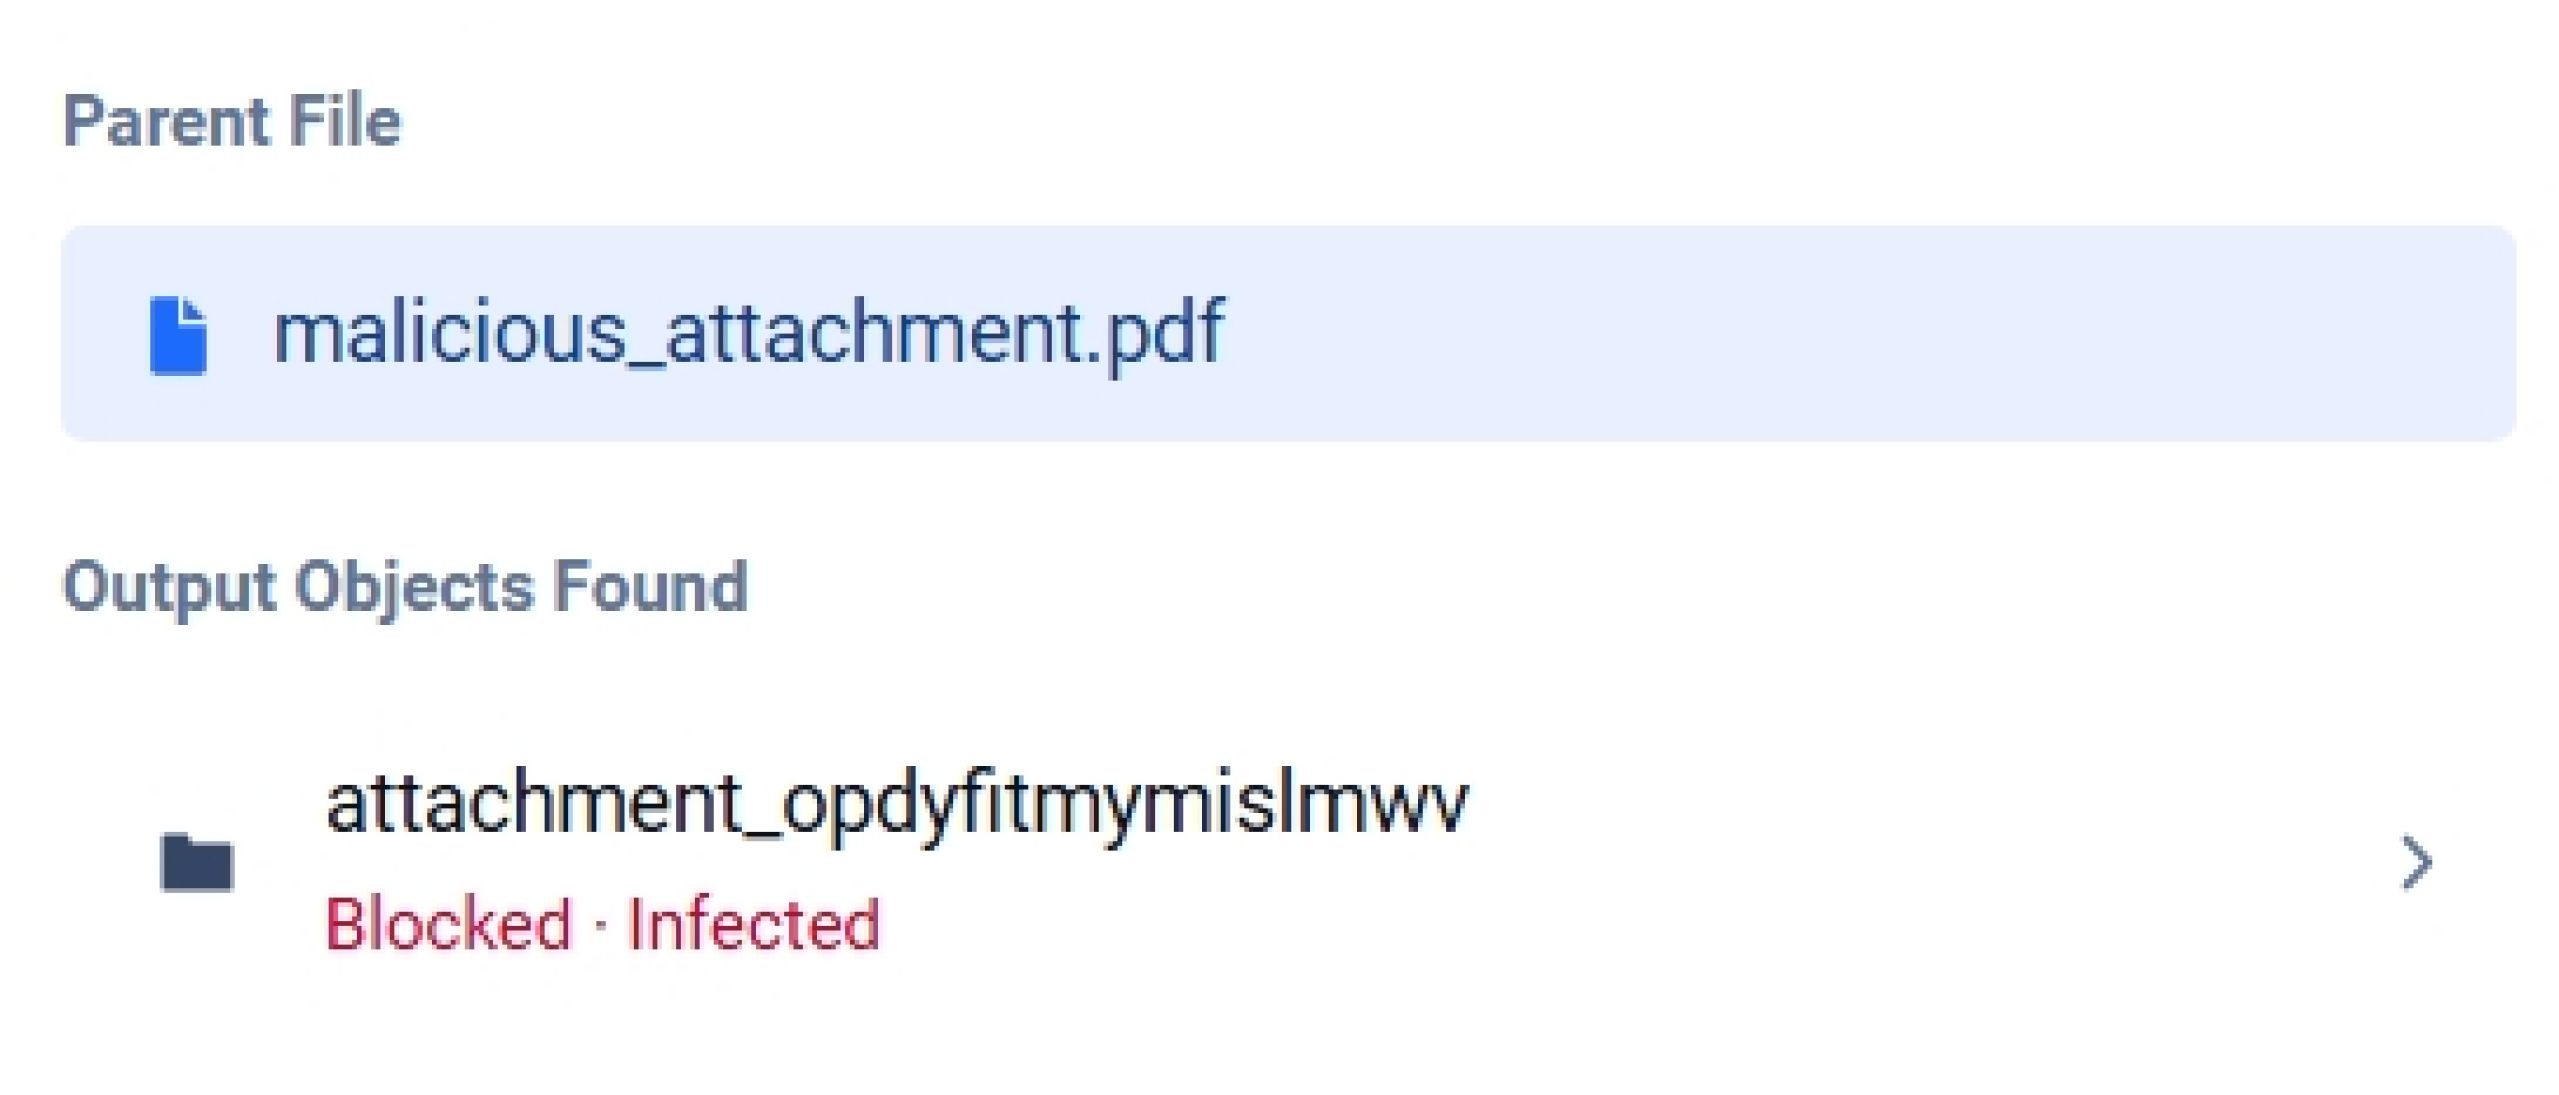
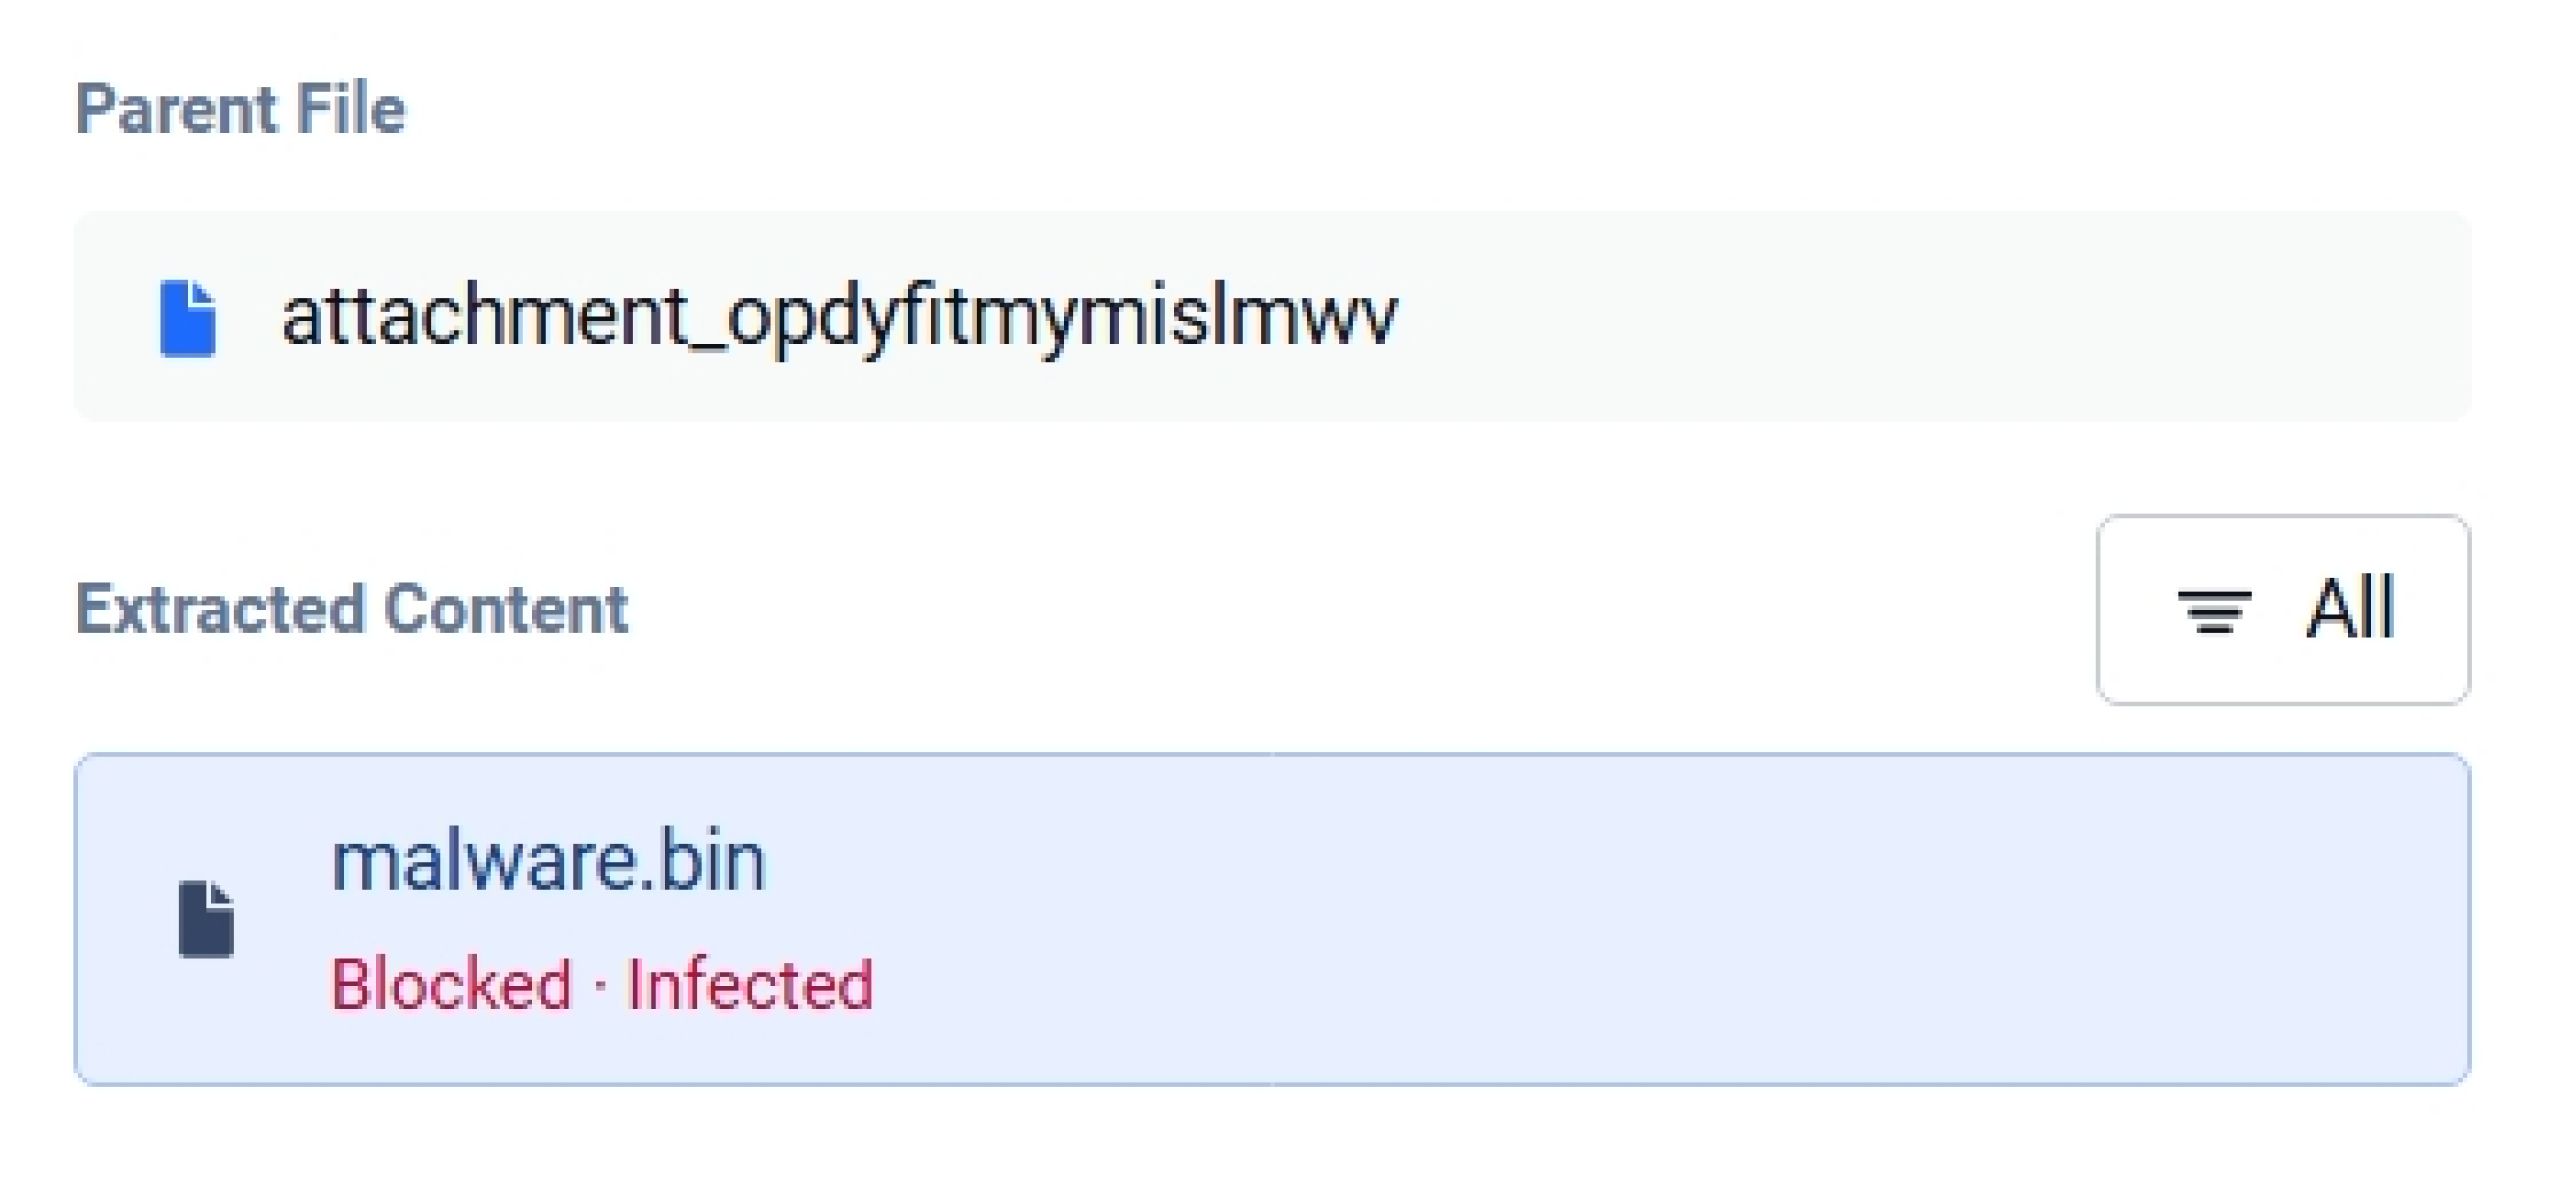
Metascan™のMultiscanning マルウェア対策エンジンは、「感染」という判定を下しました。脅威がないと判定していたのと同じシグネチャデータベースであっても、ペイロードが独立したファイルとして提示されると、感染と判定しました。
どこから始めればよいか
「クリーンなスキャン」とは、エンジンが何を解析できたかを示すものです。そのファイルに危険なものが含まれているかどうかは別の問題であり、その答えを出すことは、最初の検出エンジンを実行する前に解決しなければならない構造的な問題です。
ファイル構造の検証を単独で行うか、それともサニタイズや動的解析と組み合わせて行うかは、ファイルの種類、ワークフロー、および整合性に関する要件によって異なります。お客様の環境に適した組み合わせについては、ぜひ弊社にご相談ください。